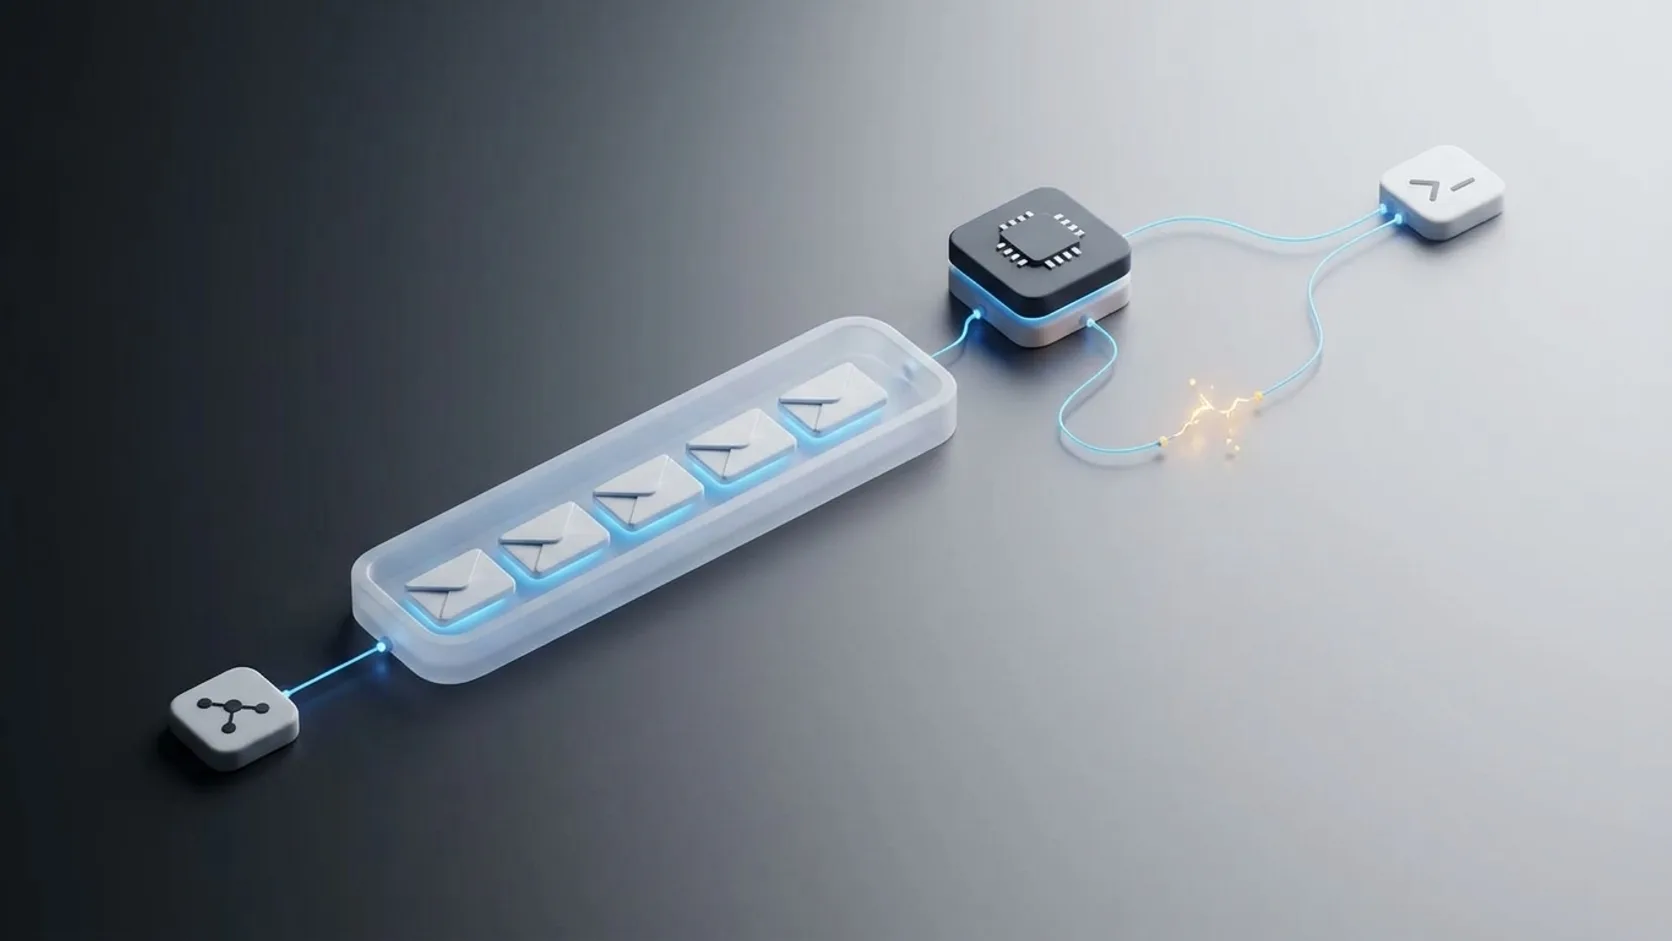
A fila que guarda o payload cru — e por que ela salvou a operação
Tem uma coisa que ninguém te conta sobre pipeline de ingestão: o problema mais caro não é o volume. É você descobrir, três dias depois, que processou tudo errado — e não ter mais o original pra reprocessar.
Essa é a história de como a nossa fila evoluiu em duas fases, e por que a segunda fase — a que parece um downgrade técnico — é a que ainda está de pé.
Fase 0: escrever direto no banco
O começo era o óbvio: mensagem chega, a gente processa e grava. Sem fila, sem buffer.
Funcionou até não funcionar. Grupo de WhatsApp não entrega volume constante — ele entrega em rajada. Fica quieto, e aí alguém manda um áudio numa discussão de 200 pessoas e vêm 400 mensagens em dois minutos. Multiplica isso por milhares de grupos e o pico não se parece nada com a média.
O sintoma clássico: a escrita no banco vira o gargalo, as conexões acumulam, e o que era pra ser um pico de dois minutos vira degradação de meia hora.
O diagnóstico aqui é bem direto: a taxa de chegada não é controlada por você, e a taxa de escrita é. Quando as duas estão acopladas, quem manda no seu banco é quem manda mensagem no grupo.
Fase 1: RabbitMQ
A resposta canônica pra esse problema é uma fila, e a gente foi de RabbitMQ.
Funcionou pro que se propunha. O pico deixou de bater direto no banco, o consumo virou uma taxa que a gente controlava, a operação parou de degradar em rajada.
Mas apareceram dois custos que eu não tinha dimensionado direito:
Mais uma peça pra operar. RabbitMQ é mais um serviço com uptime próprio, memória própria, configuração própria, modo de falha próprio. Num time pequeno, cada componente novo na infra tem um custo recorrente de atenção que não aparece no dia da decisão.
A mensagem some depois do ack. Esse é o ponto que importa. Fila é um mecanismo de transporte: entregou, processou, acabou. Ela é ótima em garantir que a mensagem chegue ao consumidor. Ela não foi feita pra responder "o que exatamente chegou aqui na terça passada?".
E era exatamente essa pergunta que a gente vivia fazendo.
O problema real não era vazão. Era reprocessamento.
Toda vez que a gente mudava uma regra de parsing, corrigia um bug de classificação ou ajustava como um tipo de mensagem era interpretado, vinha a mesma pergunta: e os dados que já passaram por aqui processados pela regra errada?
Com escrita direta, a resposta era: perdeu. Você tem o resultado do processamento, não a entrada. Se o processamento estava errado, o dado está errado e não tem de onde reconstruir.
Com RabbitMQ, a resposta era a mesma. A fila já tinha dado ack e esquecido.
Ou seja: a gente tinha resolvido o problema de vazão e continuava com o problema que mais doía no dia a dia. Bug de parsing não é evento raro — é o normal de quem ingere dado de terceiro, num formato que muda sem aviso.
Fase 2: a fila mora no Postgres, e guarda o cru
A decisão foi trocar RabbitMQ por uma fila no próprio Supabase/Postgres, com uma regra central:
Grave o payload cru, exatamente como chegou, antes de qualquer processamento. Processar é um passo posterior e repetível.
Não é uma fila no sentido de broker. É uma tabela de eventos recebidos, com o JSON original, timestamp de chegada, e um estado de processamento.
O que isso muda na prática:
| Situação | Fila tradicional | Fila com payload cru |
|---|---|---|
| Bug de parsing descoberto depois | dado perdido, sem reconstrução | reprocessa desde a origem |
| Regra de negócio mudou | vale só daqui pra frente | reaplica no histórico |
| "Por que esse registro está assim?" | inferência | lê o que chegou de fato |
| Pico de volume | absorve | absorve |
| Infra pra operar | +1 serviço | zero — já tinha Postgres |
A coluna da direita é a que descreve o nosso dia a dia. A da esquerda descreve a arquitetura que o livro recomenda.
"Mas Postgres não é fila"
É a objeção certa, e ela tem limite claro.
Fila em banco relacional tem um teto real. Em vazão muito alta, com muitos consumidores concorrentes, você vai encontrar contenção de lock, vacuum e bloat — e nesse ponto um broker dedicado é a ferramenta certa, sem discussão.
O que eu discordo é do salto que se faz a partir disso: presumir que você está nesse ponto antes de medir.
A gente não estava. E, importante: continua não estando. Essa arquitetura performa bem até hoje. O teto teórico existe e nunca foi encostado.
O que a gente ganhou foi assimétrico:
- Menos infra. O Postgres já existia, já tinha backup, já tinha monitoramento, já estava no modelo mental do time.
- Transação de verdade. Gravar o evento e atualizar o estado derivado na mesma transação elimina uma classe inteira de inconsistência entre broker e banco.
- Debug com o original na mão. "Isso está estranho" deixa de ser arqueologia. Você lê o que chegou.
- Reprocessamento como operação de rotina, não como projeto.
A ideia que sobra
Se eu tivesse que reduzir isso a uma frase, não seria "use Postgres como fila". Seria:
Separe receber de interpretar. Receber precisa ser burro, rápido e definitivo. Interpretar precisa ser repetível.
Quando esses dois passos estão colados, toda correção de regra é uma perda de dado. Quando estão separados, correção de regra vira um reprocessamento — chato, mas recuperável.
E a escolha de tecnologia — Rabbit, Kafka, SQS, uma tabela no Postgres — é a segunda pergunta. A primeira é se você ainda tem o que chegou.
Na maioria dos pipelines que eu vi de perto, a resposta é não. E é isso que custa caro, não o throughput.
Posts relacionados
RLS protege linhas. Sua coluna sensível continua exposta.
Uma policy de RLS decide quais registros uma identidade pode alcançar. Ela não escolhe quais campos essa identidade pode alterar. Dados de autoridade precisam de privilégio por coluna ou de uma mutação de servidor estreita.
robots.txt não tranca um painel interno
Excluir uma rota do rastreamento não decide quem pode receber seus dados. Painéis, relatórios e APIs internas precisam responder com autenticação e autorização no servidor antes de qualquer consulta.
Zero não é dado ausente
Quando uma API não informa uma métrica, gravar zero transforma uma lacuna de observação em uma afirmação. Preserve o desconhecido na ingestão para não fabricar resultado no dashboard.