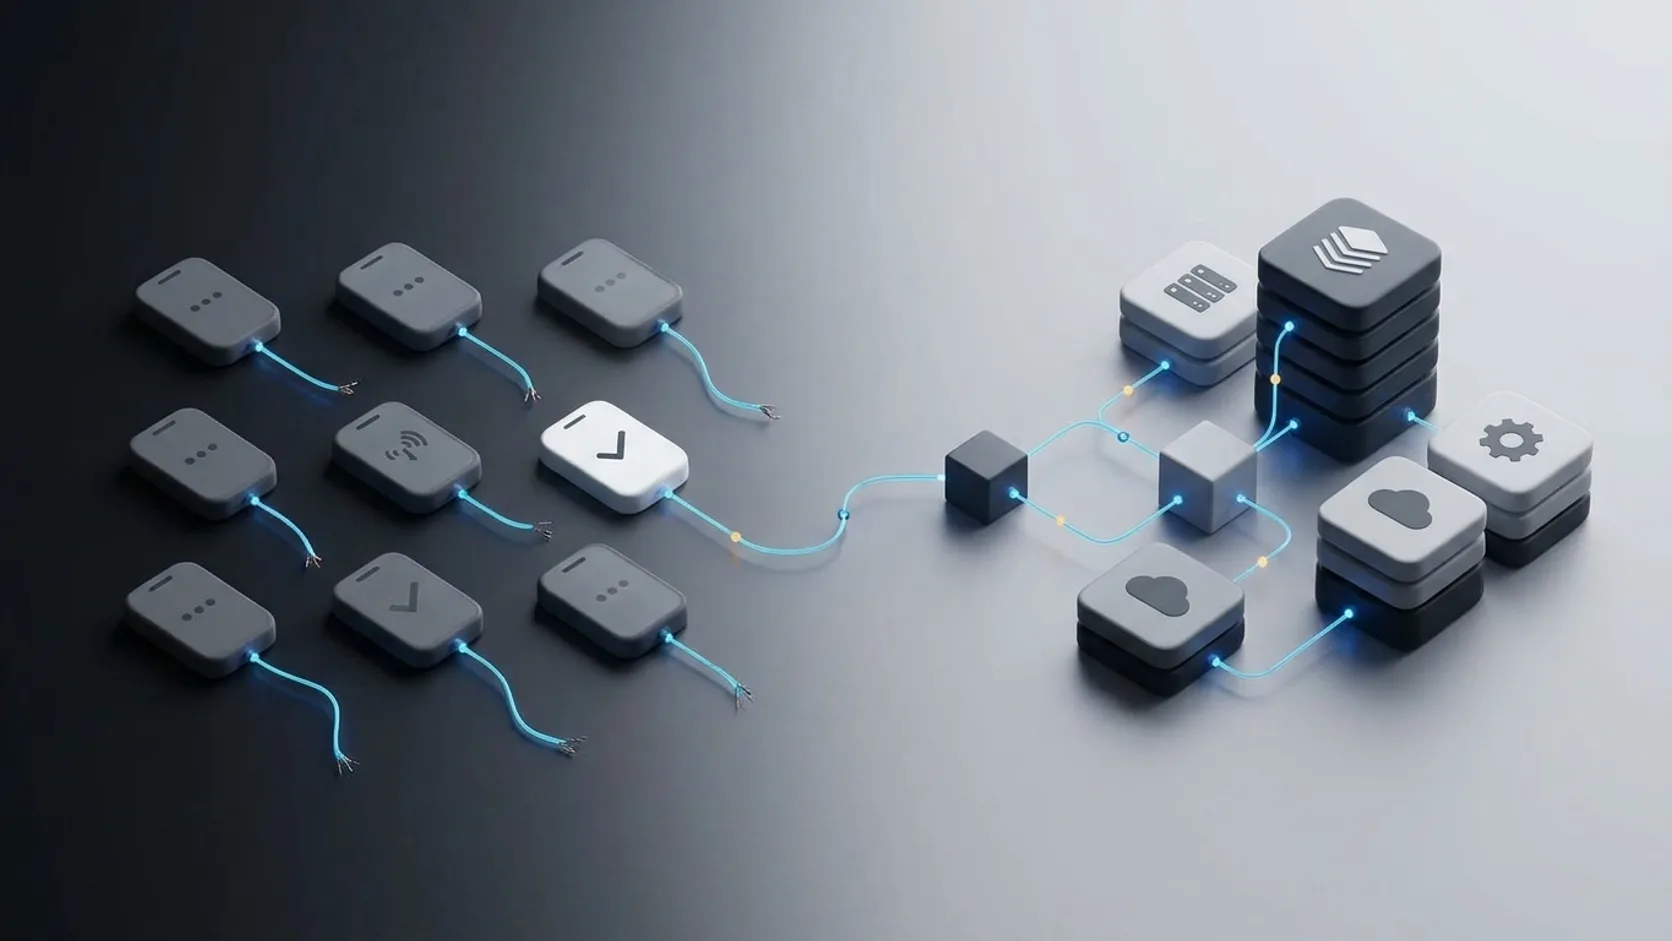
Nove números banidos numa noite: o que a gente fez nos 60 dias seguintes
O alerta não foi "os números foram banidos". Foi um gráfico chato: a ingestão de mensagens tinha caído pra zero.
A gente rodava um SaaS de analytics de grupos de WhatsApp. Dez números conectados via API não-oficial, puxando mensagem de milhares de grupos. Da noite pro dia, nove dos dez foram banidos. Não em cascata, ao longo de uma semana, dando tempo de reagir — de uma vez.
Esse texto é sobre os dois meses seguintes. Não é uma história de herói. É sobre o que acontece quando a plataforma inteira que você construiu depende de uma premissa que você não controla, e essa premissa evapora numa madrugada.
O erro não foi o ban. Foi a descoberta.
O ban a gente sabia que era possível. API não-oficial é isso: você opera num lugar onde o dono da casa pode te tirar a qualquer momento, e um dia ele tira. Risco conhecido, aceito conscientemente.
O problema real foi como a gente descobriu.
Não tinha alerta em cima da taxa de ingestão. Nenhum monitor perguntando "o volume de mensagens da última hora está dentro do esperado pra esse horário?". A gente descobriu olhando um dashboard por outro motivo e estranhando a linha reta.
Essa é a lição que eu carrego mais forte desse episódio, e ela não tem nada a ver com WhatsApp:
Se a saúde do seu produto depende de um número, esse número precisa de alarme. Não de dashboard — de alarme. Dashboard é uma coisa que alguém precisa lembrar de olhar.
Um gráfico que só é visto quando alguém decide olhar não é observabilidade. É decoração.
Duas decisões nos primeiros dias
Com nove números fora, a pergunta óbvia era: como recuperamos os números? A gente gastou pouquíssimo tempo nela. Porque a pergunta certa era outra: por que o produto inteiro morre quando um fornecedor nos bloqueia?
Aí ficou claro que a gente tinha dois problemas empilhados, não um.
Problema 1 — a operação estava em Bubble. O produto tinha nascido no-code, o que foi absolutamente a decisão certa pra validar. Mas àquela altura a gente estava tentando fazer engenharia de dados séria numa ferramenta que não foi feita pra isso. Cada mudança de schema era um exercício de paciência. Não dava pra mover rápido — e a gente precisava mover rápido.
Problema 2 — o produto era "resumo de grupos". Ou seja: o valor entregue dependia de ler cada mensagem, ao vivo, continuamente. O produto era, por definição, refém do canal de ingestão.
Ninguém decide reescrever a stack e pivotar o produto ao mesmo tempo por esporte. A gente decidiu porque os dois problemas eram o mesmo problema visto de ângulos diferentes: a arquitetura e a proposta de valor estavam ambas amarradas numa dependência frágil.
Os dois meses
Migramos 100% da operação de Bubble → Next.js + Supabase. E pivotamos de resumo de grupos → analytics de grupos.
A diferença entre os dois produtos parece sutil e não é. Resumo é um serviço contínuo: se a ingestão para hoje, o produto não entrega hoje. Analytics é sobre o acumulado: padrões, tendências, quem engaja, o que muda ao longo do tempo. Uma interrupção de ingestão vira um buraco no gráfico — não uma parada de produto.
O pivot não foi cosmético. Foi transformar a dependência mais frágil da operação num degradador de qualidade, em vez de um interruptor.
O que ajudou a caber em dois meses:
- Não migrar tudo. Migramos o que sustentava o produto novo. Um monte de coisa do Bubble simplesmente não foi junto, porque servia ao produto antigo.
- Aceitar dívida com data. Várias decisões daquele período foram explicitamente temporárias. Algumas viraram permanentes — e tudo bem, elas funcionaram.
- Manter cliente ativo o tempo inteiro. Isso não é detalhe, é a restrição que definia tudo. Não foi uma reescrita com o produto desligado.
O que eu levaria pra qualquer stack
Três coisas que sobraram desse episódio e que não têm nada de específico de WhatsApp:
1. Alarme em cima do fluxo, não só do erro. Todo mundo monitora erro 500. Bem menos gente monitora ausência: a fila que parou de encher, o webhook que parou de chegar, o cron que roda mas não processa nada. Falha silenciosa não gera exceção. Ela gera uma linha reta num gráfico que ninguém está olhando.
2. Pergunte o que morre junto. Pra cada dependência externa, a pergunta não é "e se ela cair?" — é "o que exatamente para de funcionar pro cliente quando ela cai, e por quanto tempo?". Se a resposta for "tudo, imediatamente", você não tem uma dependência. Você tem um ponto único de falha com contrato de fornecedor.
3. No-code é ótimo até a pergunta mudar. Bubble foi a escolha certa pra validar se alguém queria aquilo. Virou a escolha errada quando a pergunta passou a ser "como isso aguenta volume e muda rápido?". Não é uma crítica ao no-code — é sobre reconhecer o momento em que a ferramenta que te trouxe até aqui não te leva adiante.
O que eu não recomendo
Reescrever a stack e pivotar o produto ao mesmo tempo. A gente fez porque a alternativa era pior, não porque era uma boa ideia em abstrato.
Se você está lendo isso sem uma crise em cima, faça na ordem chata: primeiro descubra qual dependência te mata, depois desamarre o produto dela, depois mexa na stack se ainda fizer sentido. Nessa ordem você tem tempo de errar.
A gente não teve.
Posts relacionados
RLS protege linhas. Sua coluna sensível continua exposta.
Uma policy de RLS decide quais registros uma identidade pode alcançar. Ela não escolhe quais campos essa identidade pode alterar. Dados de autoridade precisam de privilégio por coluna ou de uma mutação de servidor estreita.
robots.txt não tranca um painel interno
Excluir uma rota do rastreamento não decide quem pode receber seus dados. Painéis, relatórios e APIs internas precisam responder com autenticação e autorização no servidor antes de qualquer consulta.
Read-only não é uma política de segurança
Uma tool MCP que não executa ações externas ainda precisa de contrato, autorização, limite de uso e saída tratada. O rótulo readOnlyHint não aplica nenhuma dessas garantias.